Feature Flags beginnen denkbar einfach: ein Feature ein- oder ausschalten, ohne auf das nächste Deployment zu warten. Sobald jedoch zahlreiche Teams an den gleichen Produkten, Umgebungen und Nutzergruppen arbeiten und testen, wird es schnell komplexer.
In dieser Größenordnung stellt sich längst nicht mehr die Frage, ob Feature Flags zum Einsatz kommen, sondern wie sie sich ohne zusätzliche Risiken oder unnötige Komplexität steuern lassen.
Dieser Guide betrachtet Feature Flag Management aus der Perspektive von Enterprise Experimentation.
Was ist Feature Flag Management?
Ein Feature Flag ist eine Steuerung, die festlegt, ob Nutzer auf eine bestimmte Funktionalität zugreifen können. Anstatt ein Feature direkt mit dem Deployment freizuschalten, spielen Teams den Code zuerst aus. Anschließend steuern sie gezielt, wann, wo und für wen das Feature sichtbar wird.
Feature Flag Management bezeichnet den strukturierten Prozess, diese Flags über ihren gesamten Lebenszyklus hinweg zu erstellen, zu konfigurieren, zielgerichtet auszuspielen, zu überwachen und geordnet abzubauen. Statt Flags als isolierte An/Aus-Schalter zu betrachten, verwalten Teams sie zentral über Apps, Umgebungen, Releases und Nutzergruppen hinweg.
Das trennt drei Prozesse voneinander, die bei klassischen Releases meist in einem einzigen Schritt zusammengefasst werden: Deployment, Release und Learning. Der Code wird live geschaltet, ohne sofort alle Nutzer zu erreichen. Teams steuern die Sichtbarkeit schrittweise und lernen unter realen Bedingungen, bevor sie den Rollout ausweiten, anpassen oder stoppen.
Wenn Unternehmen zahlreiche Feature-Releases und Experimente parallel fahren, schafft Feature Flag Management die nötige Struktur, damit das System auch im Wachstum kontrollierbar bleibt.
Einfach ausgedrückt: Feature Flagging steuert, ob eine Funktionalität verfügbar ist. Feature Flag Management steuert, wie Teams Flags von der Erstellung bis zum Abbau verwalten.
Wie Feature Flags Experimentation in Unternehmen vorantreiben
Feature Flags und A/B-Tests lösen unterschiedliche Aufgaben. Flags steuern, wer welche Version eines Features sieht. Ein SDK wertet dies direkt zur Laufzeit aus. Eine statistische Engine ermittelt anschließend, ob diese Version gemessen an einer definierten Metrik tatsächlich besser abschneidet.
Enterprise-Experimentation-Plattformen kombinieren beide Ansätze: Flags regeln die Bereitstellung, während die Experimentation-Engine die Messung übernimmt. Ein Flag-Split ohne Berechnung der Stichprobengröße und ohne statistische Auswertung ist lediglich ein kontrollierter Rollout, kein Experiment.
Auf Enterprise-Ebene erfordert diese Kombination auch Kontrollen darüber, wie sich die Reichweite über mehrere Releases, Experimente und Teams hinweg verändert:
Schrittweiser Rollout: Schalte neue Features zuerst für eine kleine Canary-Gruppe frei. Weite den Rollout schrittweise aus, solange die Guardrail-Metriken stabil bleiben, und schließe ihn erst ab, wenn jede Phase erfolgreich verläuft. Unser Guide für progressive Rollouts beschreibt dieses dreistufige Framework im Detail: Canary-Phase, erweiterte Validierung und vollständiger Rollout.
Kill-Switches: Deaktiviere ein Feature sofort für alle Nutzer, sobald ein Fehler auftritt, ohne auf das Deployment eines Hotfixes zu warten.
Gegenseitiger Ausschluss: Stelle sicher, dass Nutzer in einem Experiment nicht gleichzeitig in einem zweiten, sich überschneidenden Experiment landen. Das verhindert unerwünschte Wechselwirkungen zwischen Tests.
Teamübergreifende Transparenz: Gib Produkt- und Tech-Teams vollen Einblick in aktive, geplante und per Flag gesteuerte Features, damit sie überschneidende Releases und Experimente reibungslos koordinieren.
„Die Bereitstellung eines Features ist eine technische Entscheidung. Das Release ist eine geschäftliche Entscheidung. Das Rollback ebenfalls. Feature Flags geben dir die Freiheit, all das ganz einfach und exakt zum gewünschten Zeitpunkt umzusetzen.“
Mahek Mahendra Shah, Director of Product Management bei Wingify (Quelle:Podcast)
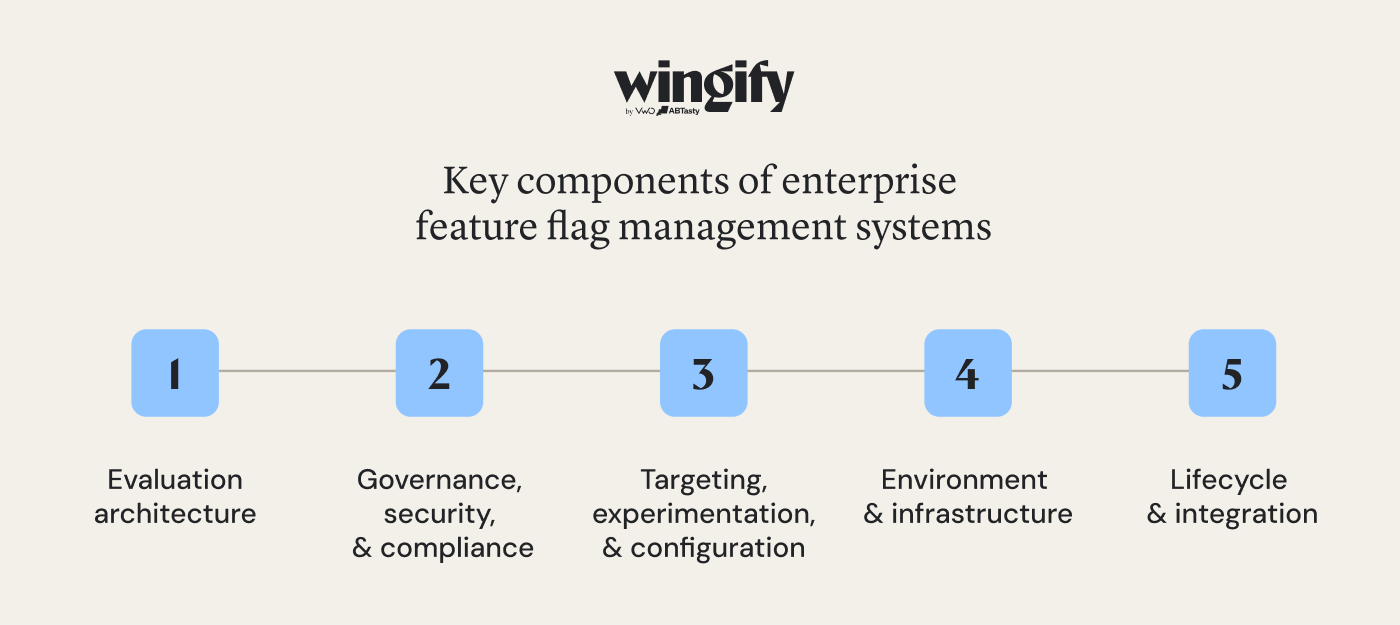
Management-Systeme für Enterprise Feature Flags: Die wichtigsten Komponenten
Die besten Enterprise-Systeme für Feature Flag Management bieten weit mehr als einen simplen Toggle Switch. Genau diese Komponenten entscheiden darüber, ob ein System auch mit vielen Teams, unterschiedlichen Umgebungen und strengen Compliance-Vorgaben mühelos skaliert.
1. Evaluierungs-Architektur
Lokale SDK-Auswertung: Serverseitige Feature Flag Systeme treffen Entscheidungen direkt in der Anwendung über lokal verfügbare Konfigurationsdaten. Für einzelne Prüfungen ist keine Netzwerkanfrage nötig. Das senkt die Latenz und verhindert langsame Remote-API-Aufrufe während der Anfrage. Wingify Feature Management nutzt beispielsweise eine lokale In-Memory-Auswertung für serverseitige SDK-Entscheidungen, sodass hier keine Netzwerkaufrufe nötig sind.
Konfiguration in Echtzeit synchronisieren: Änderungen übertragen sich über Streaming oder Polling direkt auf die Anwendungs-SDKs. Dafür ist weder ein Neustart der App noch ein neues Deployment nötig.
Ausfallsichere Standardwerte: Ein klar definiertes Fallback-Verhalten greift, wenn sich ein Flag nicht wie erwartet auswerten lässt. Das verhindert, dass das Verhalten des Features undefiniert bleibt.
2. Governance, Sicherheit und Compliance
Rollenbasierte Zugriffskontrolle (RBAC) nach Umgebungen: Steuert genau, wer Flags erstellen, Targeting-Regeln anpassen oder Feature Flags in der Produktion ändern darf.
Genehmigungsworkflows: Überprüfung durch mehrere Personen für risikoreiche Änderungen in der Produktion, bevor diese für den Live-Traffic freigeschaltet werden.
Audit-Logs: Erfassen lückenlos, wer wann was an einem Flag geändert hat. Das erleichtert die Fehlersuche, sorgt für Transparenz und unterstützt Compliance-Audits.
SSO und IP-Allowlisting: Sichern den Zugriff über Enterprise-Identity-Provider und Netzwerkregeln.
Compliance und Datenstandort: Erfüllen relevante Sicherheits- und Datenschutzanforderungen durch SOC-2- und ISO-27001-Zertifizierungen, Vorgaben wie DSGVO und CCPA sowie flexible Optionen zur Datenhaltung.
3. Zielgruppenansprache, Experimentation und Konfiguration
Targeting-System: Bewertet Flags anhand von Nutzerattributen, Segmenten und prozentualen Rollout-Regeln, um zu bestimmen, welche Nutzer ein Feature oder eine Variante erhalten.
Experimentation und Messung: Verknüpft Flag-Zuweisungen mit definierten Metriken und statistischen Analysen. So können Teams fundiert prüfen, ob Unterschiede zwischen Varianten signifikant sind, anstatt die reine Traffic-Verteilung bereits als Experiment zu werten.
Remote-Konfiguration: Ermöglicht Teams das Anpassen von Variablen und Konfigurationsparametern. Dazu gehören Strings, Zahlen, Booleans sowie JSON-basierte Einstellungen für Algorithmusparameter, ganz ohne neues Deployment.
4. Umgebungen und Infrastruktur
Support für mehrere Umgebungen: Hält separate Flag-Zustände für Entwicklung, Staging und Produktion bereit. So können Teams Features gründlich testen, bevor diese live geschaltet werden.
Deployment-Optionen: Je nach Tool bieten Anbieter Managed Service, Private-Cloud- oder Self-Hosting-Modelle an. Das ist besonders für Organisationen wichtig, die spezielle Anforderungen an Infrastruktur, Sicherheit oder Datenhaltung haben.
5. Lebenszyklus und Integrationen
Tools für den Flag-Lebenszyklus: Helfen dabei, veraltete oder ungenutzte Flags zu identifizieren. So können Teams veralteten Code und ungenutzte Flags rechtzeitig entfernen, bevor sich diese als technische Schulden anhäufen.
API- und CI/CD-Integration: REST-APIs und Developer-Tools ermöglichen es Teams, Flags direkt über CI/CD-Pipelines und interne Systeme zu erstellen, zu schalten, zu aktualisieren oder zu archivieren, anstatt sich rein auf das Dashboard zu verlassen.
Data-Warehouse- und Analyse-Integration: Daten aus Flag-Evaluierungen und Experimenten fließen direkt in bestehende Analyse- und Datensysteme ein. So führen Teams umfassende Produkt- und Business-Analysen durch, anstatt Daten isoliert in der Feature Management Plattform zu halten.
Pro Tip!
Das Feature Management von Wingify bietet Empfehlungen zum Abbau technischer Schulden. Es erkennt ungenutzte Feature Flags und zeigt präzise, wo sich diese im Code befinden, inklusive Datei und Zeilennummer. So wird die Bereinigung veralteter Flags fester Bestandteil des regulären Feature-Lebenszyklus, ohne dass Entwickler die Codebasis manuell durchsuchen müssen.
Erfolgsfaktoren für das Feature Management in Unternehmen
Feature Flags im Enterprise-Einsatz erfordern klare Strukturen für Zuständigkeiten, Rollouts, Monitoring und Cleanup. Einige der wichtigsten Praxis-Empfehlungen umfassen:
Flag-Typen, Zuständigkeiten und Namensgebung vorab definieren: Flags frühzeitig als vorübergehend oder dauerhaft klassifizieren, eine verantwortliche Person zuweisen, teamübergreifend einheitliche Namenskonventionen nutzen und ein Löschdatum für temporäre Flags festlegen.
Rollback-Bedingungen vor dem Release festlegen: Messbare Schwellenwerte und Guardrail-Metriken definieren, die klar vorgeben, wann Teams einen Rollout stoppen oder rückgängig machen müssen.
Kill-Switches vorab testen: Sicherstellen, dass das Deaktivieren eines Flags die betroffene UI, APIs und nachgelagerte Abhängigkeiten sauber abfedert.
Sinnvoll automatisieren: Zeit- oder metrikbasierte Regeln nutzen, um Feature Rollouts voranzutreiben, zu pausieren oder rückgängig zu machen, anstatt sich rein auf manuelles Monitoring zu verlassen.
Zugriffe nach Umgebung steuern: Teams in Entwicklung und Staging Flexibilität gewähren, für die Produktion hingegen strengere Berechtigungen und Freigabeprozesse durchsetzen.
Stabilität und Wert getrennt überwachen: Technische Guardrails parallel zu den Produkt- oder Business-Metriken verfolgen, die das Feature verbessern soll.
Flags für Experimentation statt reiner Releases nutzen: Feature-Varianten vor einer dauerhaften Umstellung mit definierten Metriken und statistischen Analysen verknüpfen.
Weiterführende Leseempfehlungen:Vertiefende Einblicke zu Erfolgsfaktoren beim Feature Management findest du auf unseremBlog.
Häufige Herausforderungen beim Feature Flag Management in Unternehmen
Wenn Feature Flags in immer mehr Produkten und Teams zum Einsatz kommen, steigen auch die Herausforderungen:
Veraltete Toggles: Wenn Flags länger im Code bleiben als das eigentliche Feature, sammeln sie sich als tote Bedingungen an. Das überlädt die Codebase und bremst die Fehlersuche in veralteten Pfaden unnötig aus.
Schwer zu testende Flag-Kombinationen: Greifen mehrere Feature-Toggles auf demselben Codepfad ineinander, entstehen oft mehr Zustände, als die QA vor dem Release testen kann.
Unkoordinierte Flags ohne zentrale Übersicht: Erstellen Teams unabhängig voneinander Flags ohne zentrales System, testen sie oft dieselbe Stelle für widersprüchliche Ziele. Das böse Erwachen kommt erst, wenn die Ergebnisse nicht mehr zusammenpassen.
Fehler bei der Zielgruppenausrichtung : Falsche Nutzerattribute oder Regeln können dazu führen, dass ein Feature der falschen Zielgruppe angezeigt wird. Das gefährdet sowohl den Rollout als auch darauf aufbauende Experimente.
Umgebungsabweichungen: Ein Flag verhält sich in Staging und Produktion manchmal unterschiedlich. Auslöser dafür sind abweichende SDK-Versionen, Konfigurationen, Targeting-Regeln oder andere umgebungsspezifische Einstellungen. Das erzeugt Bugs, die sich nur schwer zum eigentlichen Flag zurückverfolgen lassen.
Veraltete App-Evaluierungen: Entfernt man ein Flag aus der Konfiguration, werten ältere App-Versionen auf den Geräten der Nutzer es oft trotzdem weiter aus. Denn im Gegensatz zu Web-Apps lassen sich Mobile Clients nicht einfach zu einem Update zwingen.
Anbieterabhängigkeit: Proprietäre SDKs und geschlossene Formate machen einen Plattformwechsel teuer. Das gilt besonders bei jahrelanger Flag-Historie und tiefer Code-Integration. OpenFeature verringert die Abhängigkeit vom Anbieter, indem es eine neutrale API für die Flag-Auswertung bietet.
Ziel ist nicht, diese Risiken vollständig auszuschließen. Es geht darum, sie transparent und kontrollierbar zu machen, sobald der Einsatz von Flags teamübergreifend zunimmt.
Top-Anwendungsfälle für das Feature Flag Management auf Experimentation-Plattformen
Progressiver Feature Rollout: Statt ein Feature sofort für 100 % der Nutzer freizugeben, veröffentlichst du es zuerst für ein kleines Segment. Danach erweiterst du die Verfügbarkeit schrittweise auf Basis von Guardrail-Metriken und relevantem Nutzer-Feedback.
Sofortige Kill-Switches und Rollbacks: Schalte ein fehlerhaftes Feature sofort ab, sobald deine Guardrail-Metriken einen Grenzwert überschreiten. Ganz ohne Warten auf ein Hotfix-Deployment. E-Commerce-Teams nutzen das vor allem an Tagen mit extrem viel Traffic wie dem Black Friday: Sie sichern Checkout-Flows und zeitlich begrenzte Rabatt-Aktionen mit Flags ab und deaktivieren sie mit einem Klick, falls etwas schiefgeht.
Beta- und Early-Access-Programme: Schalte ein Feature vor dem offiziellen Launch für interne Nutzer, bestimmte Tarife oder eine Test-Gruppe frei. Nutze dafür genau die Targeting-Infrastruktur, die auch deine kontrollierten Experimente steuert. SaaS- und B2B-Teams steuern Flags so gezielt nach Account- oder Tenant-ID. Sie rollen neue Features erst für ausgewählte Enterprise-Kunden aus, bevor sie für alle live gehen.
Trunk-Based Development: Integriere unvollständige Features hinter einer Flag direkt in den Hauptcode. So bleibt deine Codebasis einheitlich. Du vermeidest veraltete Testzweige, die mit der Zeit auseinanderdriften und deren Zusammenführung unnötig viel Zeit kostet.
Full-Stack-A/B Testing: Flags teilen Nutzer direkt im Frontend und Backend in verschiedene Testgruppen ein. Die Experimentation-Ebene misst dabei automatisch, welche Variante im Vergleich zu deinen definierten Metriken besser abschneidet.
Personalisierte Zielgruppenansprache nach Nutzermerkmalen: Spiele unterschiedliche Inhalte für verschiedene Nutzersegmente aus, basierend auf Tarifstufe, Region oder anderen Attributen. Nutze dafür genau die Flag-Infrastruktur, mit der du auch deine kontrollierten Experimente steuerst.
Testen von Konfigurations- und Algorithmusänderungen: Steuere Parameter wie Empfehlungslogik, Preiskonfiguration oder Suchranking flexibel als Flag-Variablen. So testest du Anpassungen direkt im Live-System, ohne für jede Variante ein eigenes Code-Deployment starten zu müssen.
So wählst du die richtige Plattform für dein Feature Flag Management
Die richtige Plattform für dein Feature Flag Management muss genau dazu passen, wie deine Teams Features entwickeln, veröffentlichen, testen und steuern. Achte bei der Tool-Auswahl nicht nur auf reine Feature-Listen. Entscheidend sind die Anforderungen, die deinen Arbeitsalltag und deine langfristige Skalierbarkeit wirklich beeinflussen:
Bringt die Lösung eine eigene Statistik-Engine mit oder liefert sie nur Flags aus? Eine Feature-Delivery-Plattform ohne integrierte statistische Auswertung erfordert ein separates Experimentation- oder Analytics-System. Nur so findest du heraus, ob die Unterschiede zwischen deinen Varianten wirklich signifikant sind.
Welche SDKs für deine Programmiersprachen bietet die Plattform? Passt das zu deinem Tech-Stack? Vergewissere dich, dass deine Teams Feature Flags in allen verwendeten Sprachen einbinden können. Ein reines JavaScript-SDK für den Browser greift da oft zu kurz.
Self-Hosted oder Managed Service? Mit einer Self-Hosted-Lösung behältst du die volle Kontrolle über Infrastruktur und Datenspeicherorte, übernimmst aber auch den gesamten Wartungs- und Setup-Aufwand. Ein Managed Service lagert diese betriebliche Verantwortung größtenteils an den Anbieter aus.
Bietet die Plattform Enterprise-Sicherheit? Achte auf detaillierte Zugriffskontrollen und Audit-Logs. So erfasst du nicht nur das Erstellen von Flags, sondern auch alle späteren Änderungen an Targeting-Regeln und Konfigurationen.
Wie geht die Plattform mit mehreren Umgebungen um? Du kannst für Entwicklung, Staging und Produktion jeweils eigene Flag-Zustände, Berechtigungen und Konfigurationen verwalten. Umständliche Workarounds brauchst du dafür nicht.
Wie steuert die Plattform den Lebenszyklus von Flags? Achte nicht nur auf das Erstellen von Flags, sondern auch auf klare Zuständigkeiten, Status-Tracking und die regelmäßige Bereinigung. Ohne diesen Prozess wachsen technische Schulden durch veraltete Toggles schnell an.
Wie ist das Preismodell strukturiert? Abrechnungen bei Feature Flag-Plattformen basieren oft auf Teammitgliedern, Nutzung, getrackten Nutzern oder individuellen Enterprise-Verträgen. Vergleiche genau, wie sich deine Kosten verändern, wenn Teams, Umgebungen, Flag-Evaluierungen und das Experimentiervolumen wachsen.
Fazit: Wie Wingify Feature Management und Experimentation verbindet
Professionelles Feature Flag Management geht weit darüber hinaus, Releases zeitlich und regional zu steuern. Wenn Projekte und Teams wachsen, musst du Änderungen gezielt ausrollen, diese evaluieren, Zugriffe regeln und Flags über alle Produkte und Umgebungen hinweg sauber im Blick behalten.
Wingify Feature Management bettet Feature Flags in den gesamten Feature-Lebenszyklus ein. Deine Teams steuern Flags über alle Umgebungen hinweg, rollen Features schrittweise aus oder ziehen sie zurück, führen kontrollierte Tests mit Feature Experimentation durch und stimmen Inhalte über Feature Personalization gezielt ab. Der gleiche Flag dient dabei für den Rollout, das Experiment und die Personalisierungskampagne. So mussst du keine getrennten Bereitstellungs- und Mess-Workflows mehr mühsam kombinieren.
Wingz als integrierter AI-Layer liefert dir den nötigen Kontext aus Releases, Experimenten, Metriken und Nutzerverhalten. So analysierst du Auswirkungen im Handumdrehen und weißt genau, welche Schritte als Nächstes anstehen.
Meliá Hotels International nutzte Feature Experimentation innerhalb von Wingify Feature Management, um einen neuen Schritt im Buchungs-Funnel sicher auszurollen. Das Team startete mit nur 5 % der Nutzer, überwachte die Conversion-Raten und skalierte den Rollout innerhalb einer Woche auf 100 %, ganz ohne höhere Abbruchraten. Die Änderung brachte zusätzlich 1,85 % mehr durchschnittlichen Umsatz pro Besucher. Lieshierdie vollständige Erfolgs-Story.
Fordere eine Demo an und sieh selbst, wie Wingify Feature Management Feature Flags, kontrollierte Rollouts, Experimentation und Wirkungsmessung in deinem gesamten Tech-Stack verbindet.
FAQs
Was ist Feature Flag Management in Experimentation-Plattformen?
Feature Flag Management bezeichnet den Prozess, Feature Flags innerhalb einer Experimentation-Plattform zu erstellen, gezielt zuzuweisen, zu überwachen und wieder zu deaktivieren. Es erlaubt Teams, die Bereitstellung von Features zu steuern und Varianten direkt mit Metriken sowie statistischen Analysen zu verknüpfen.
Wie verbessern Feature Flags A/B-Tests?
Feature Flags entkoppeln das Deployment von Features von ihrer Freigabe für Nutzer. Du kannst Nutzer ganz ohne neues Deployment verschiedenen Varianten zuweisen, die Auswirkungen messen und den Gewinner direkt ausrollen oder eine fehlerhafte Variante ohne erneuten Code-Push deaktivieren.
Sind Feature Flags auch für nicht-technische Teams geeignet?
Ja, mit der passenden Plattform und den richtigen Berechtigungen. Produkt- und Business-Teams können Targeting, Rollout-Quoten und Experimente ganz einfach über ein Dashboard steuern, während das Tech-Team nur die initiale SDK-Einbindung und den Flag-Code übernimmt.
Stephanie Safdie hat einen Bachelorabschluss in englischer Sprache und Literatur von der University of Maryland mit Schwerpunkt Multimedia Studies. Sie war als Video-Creatorin, Freelance-Copywriterin und SEO-Copywriterin bei Greenly tätig und betreibt den Reiseblog Destination Dreamer Diaries.
Vielleicht lesen Sie diese auch gerne
13 Min. Lesezeit
7 Top A/B Testing-Tools mit Heatmaps für 2026
4 Min. Lesezeit
Neugier trifft auf Klarheit: Warum wir zu Wingify wurden
11 Min. Lesezeit
Datenüberlastung: Wie Wingz Signale in klare Optimierungen umwandelt
Der bessere Weg, zu testen,zu lernen und zu wachsen