Bei jedem A/B-Test entscheidest du dich bewusst oder unbewusst für eine statistische Methode.
Zwei Ansätze bestimmen, wie wir Testergebnisse interpretieren: frequentistisches und bayesianisches A/B-Testing. Darüber wird leidenschaftlich diskutiert, denn die praktischen Folgen sind erheblich. Wingify hat sich hierzu klar positioniert.
Ob du gerade eine A/B-Testing-Plattform auswählst, erst mit Experimentation startest oder deine Ergebnisse besser verstehen möchtest: Die Unterschiede zwischen beiden Methoden sind entscheidend. Sie trennen belastbare Erkenntnisse von bloßen Vermutungen, und echte Gewinner von vermeintlichen Erfolgen.
Schauen wir uns die beiden Ansätze genauer an.
Was ist Inferenzstatistik?
Frequentistische und bayesianische Methoden gehören beide zur Inferenzstatistik.
Während die deskriptive Statistik lediglich beschreibt, was bereits geschehen ist, hilft die Inferenzstatistik dabei, Aussagen für die Zukunft abzuleiten. Ergebnisse aus einer Stichprobe lassen sich auf eine größere Zielgruppe übertragen.
Die zentrale Frage lautet: Würde Variante A oder Variante B besser performen, wenn du sie für deine gesamte Zielgruppe ausrollst?
Ein kurzes Beispiel
Angenommen, du untersuchst olympische Schwimmer. Mit deskriptiver Statistik könntest du Folgendes berechnen:
- die durchschnittliche Körpergröße des Teams
- die Streuung der Körpergröße innerhalb des Teams
- die Verteilung oberhalb und unterhalb des Durchschnitts
Das ist hilfreich, hat aber seine Grenzen.
Mit Inferenzstatistik kannst du einen Schritt weitergehen. Möchtest du zum Beispiel die durchschnittliche Körpergröße aller Männer weltweit kennen, kannst du unmöglich jeden Einzelnen vermessen. Du kannst den Wert aber aus kleineren, repräsentativen Stichproben ableiten.
Genau hier kommen frequentistische und bayesianische Methoden ins Spiel. Beide treffen auf Basis unvollständiger Daten Prognosen, gehen dabei jedoch unterschiedlich vor, insbesondere im A/B Testing.
Wie funktioniert A/B Testing mit der frequentistischen Methode?
Der frequentistische Ansatz ist die klassische Methode. Wahrscheinlich kennst du ihn aus Statistikvorlesungen oder aus vielen gängigen A/B-Testing-Tools.
Einer der zentralen Unterschiede zwischen frequentistischem und bayesianischem A/B-Testing: Die frequentistische Statistik betrachtet langfristige Häufigkeiten und arbeitet mit fest definierten Hypothesen.
So funktioniert das Verfahren:
Die Hypothese
Zu Beginn gehst du davon aus, dass zwischen Variante A und Variante B kein Unterschied besteht. Diese Annahme heißt Nullhypothese.
Am Ende des Tests erhältst du einen p-Wert (Wahrscheinlichkeitswert). Er beschreibt, wie wahrscheinlich deine beobachteten (oder noch extremeren) Ergebnisse wären, falls zwischen den Varianten tatsächlich kein Unterschied besteht. Vereinfacht gesagt: Wie wahrscheinlich ist es, dass das Ergebnis zufällig zustande kam?
Je kleiner der p-Wert, desto stärker spricht das Ergebnis gegen die Nullhypothese und für einen echten Unterschied zwischen den getesteten Varianten.
| Frequentistischer Ansatz: Vorteile | Frequentistischer Ansatz: Nachteile |
|---|---|
| Schnelle Berechnung: Frequentistische Modelle lassen sich effizient berechnen und sind in praktisch jeder Statistikbibliothek verfügbar. | Kein vorzeitiges Prüfen: Der p-Wert kann erst am Ende des Tests interpretiert werden. Wer Ergebnisse vorzeitig und wiederholt betrachtet, riskiert irreführende Schlussfolgerungen, weil aus einem Experiment faktisch mehrere Experimente werden. |
| Weit verbreitet: Der Ansatz ist Standard in vielen Statistikkursen und A/B-Testing-Tools. | Keine Schätzung des Umsatzbeitrags: Du erfährst, welche Variante gewinnt, aber nicht, wie groß der erwartbare Effekt ist. Das erschwert wirtschaftliche Entscheidungen im A/B Testing. |
Wie funktioniert bayesianisches A/B Testing?
Der bayesianische Ansatz wählt einen anderen Weg und ist aus unserer Sicht für viele A/B-Testing-Szenarien die bessere Wahl.
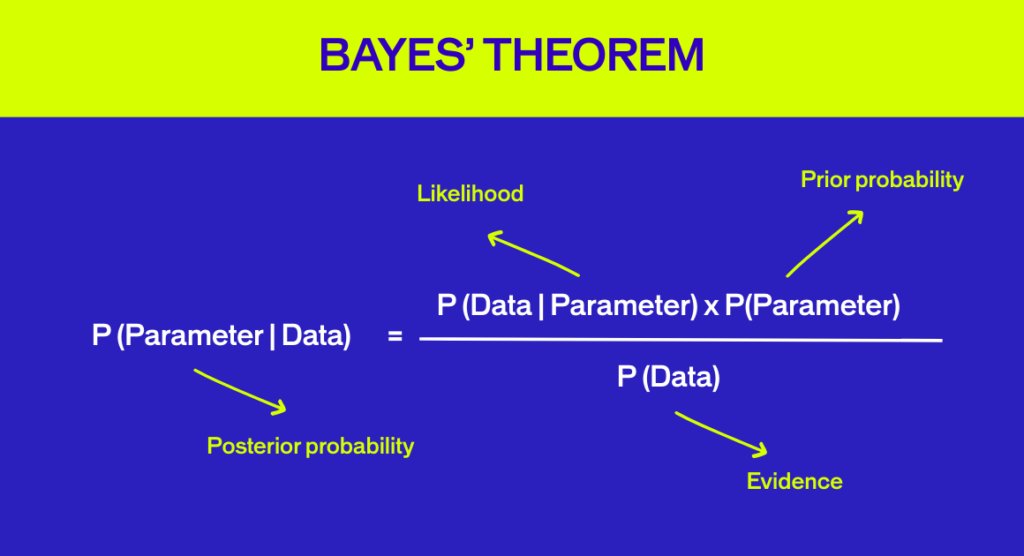
Die Methode ist nach dem britischen Mathematiker Thomas Bayes benannt. Sie bezieht Vorwissen in die Analyse ein und basiert auf drei miteinander verknüpften Elementen.
Die drei Säulen der bayesianischen Analyse
- Prior: Informationen aus früheren Experimenten. Zu Beginn verwenden wir einen „nicht-informativen“ Prior, also ein unbeschriebenes Blatt.
- Evidenz: Die Daten aus deinem aktuellen Experiment.
- Posterior: Die aktualisierte Einschätzung, die Prior und Evidenz miteinander verbindet. Sie bildet dein Ergebnis.
Der grundlegende Vorteil: Bayesianisches A/B-Testing ist für laufende Experimente konzipiert. Jedes Mal, wenn du die Daten prüfst, werden die bisherigen Ergebnisse zum neuen Prior und neu eingehende Daten zur Evidenz.
Das bedeutet: Ein Blick auf Zwischenergebnisse ist Teil des Verfahrens. Die Analyse bleibt bei jeder erneuten Auswertung gültig.
Noch wichtiger für die Praxis: Mit bayesianischer Statistik kannst du nicht nur bestimmen, welche Variante gewinnt, sondern auch den wahrscheinlichen Uplift abschätzen. Für Geschäftsentscheidungen ist das ein bedeutender Unterschied.
| Bayesianischer Ansatz: Vorteile | Bayesianischer Ansatz: Nachteile |
|---|---|
| Zwischenergebnisse sicher prüfen: Du kannst laufende Daten betrachten, ohne die Aussagekraft der Analyse zu gefährden. Schwache Varianten lassen sich früher stoppen, Gewinner schneller skalieren. | Höherer Rechenaufwand: Das Verfahren benötigt Stichprobenschleifen und damit bei großer Skalierung mehr Rechenleistung. Für Anwender hat das jedoch keine praktischen Nachteile. |
| Uplift sichtbar machen: Du kennst nicht nur den Gewinner, sondern auch die Bandbreite der erwartbaren Verbesserung. | |
Weniger Fehlentscheidungen: Der Ansatz hilft dabei, falsch-positive Ergebnisse frühzeitig auszusortieren. |
Frequentistisches und bayesianisches A/B-Testing im Vergleich
Beide Methoden sind statistisch valide. In der Praxis führen sie jedoch zu sehr unterschiedlichen Möglichkeiten, Testergebnisse zu interpretieren und Entscheidungen zu treffen.
Wingify bevorzugt klar den bayesianischen Ansatz.
Dafür gibt es gute Gründe.
Die Größe des Uplifts zählt
Beim bayesianischen A/B Testing weißt du nicht nur, welche Variante gewonnen hat, sondern auch, wie groß der erwartbare Vorteil ist.
Das ist für Unternehmen bedeutend: Bei einem A/B-Test musst du letztlich entscheiden, ob sich der Wechsel von Variante A zu Variante B lohnt.
Dabei spielen unter anderem folgende Faktoren eine Rolle:
- Implementierungskosten wie Zeit, Ressourcen und Budget
- Folgekosten wie Anbietergebühren, Lizenzen oder Wartung
Beispiel: Du testest einen Chatbot auf deiner Preisseite. Variante B mit Chatbot übertrifft Variante A. Die Umsetzung erfordert jedoch zwei Wochen Entwicklungszeit und zusätzlich eine monatliche Lizenz.
Jetzt musst du wissen, ob sich die Investition rechnet. Bayesianische Statistik unterstützt diese Entscheidung, indem sie den erwartbaren Uplift des Experiments quantifiziert.
Praxisbeispiel aus dem Reporting von Wingify
Betrachten wir einen Test mit drei Varianten und einer Originalversion. Als KPI dienen Klicks auf den CTA.
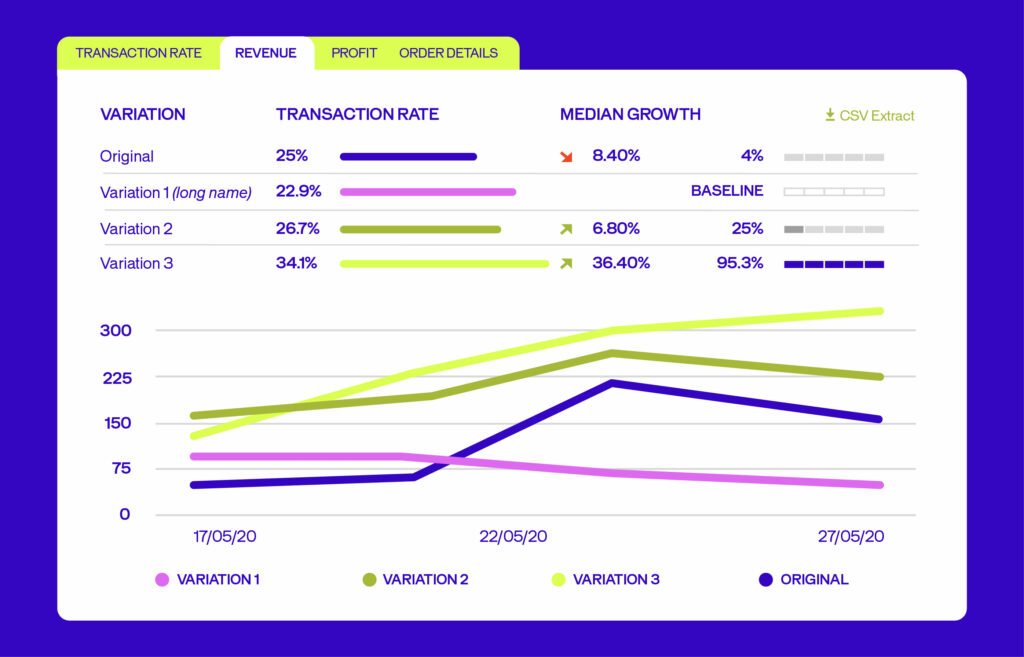
Variante 3 gewinnt mit einer Konversionsrate von 34,1 % gegenüber 25 % beim Original.
Spannend wird es bei der Bandbreite des Effekts:
- Mittlerer Uplift: +36,4 %
- Niedrigster plausibler Uplift: +2,25 %
- Höchster plausibler Uplift: +48,40 %
In 95 % der Fälle liegt der Uplift demnach zwischen +2,25 % und +48,40 %.
Diese Detailtiefe hilft dir zu entscheiden, ob du den Gewinner ausrollen solltest:
- Beide Intervallgrenzen sind positiv? Ein sehr gutes Zeichen.
- Das Intervall ist eng? Hohe Sicherheit, die Umsetzung spricht für sich.
- Das Intervall ist breit, die Implementierung aber günstig? Dann kannst du das Risiko häufig eingehen.
- Das Intervall ist breit und die Umsetzung teuer? Warte besser auf weitere Daten.
Das Beispiel zeigt konkret, wie unterschiedlich sich frequentistische und bayesianische Methoden auf die Qualität von Geschäftsentscheidungen auswirken.
Wann sind Testergebnisse vertrauenswürdig?
Wingify empfiehlt, mindestens folgende Richtwerte zu erreichen:
- mindestens 5.000 Unique Visitors pro Variante
- eine Testlaufzeit von mindestens 14 Tagen beziehungsweise zwei Geschäftszyklen
- 300 Conversions auf das Hauptziel
Diese Schwellenwerte gelten unabhängig von der gewählten Methode. Sobald sie erreicht sind, liefert bayesianisches A/B Testing jedoch besonders gut interpretierbare Ergebnisse.
Zwischenergebnisse prüfen: Ein Vorteil des bayesianischen Ansatzes
Stell dir vor, du testest eine wichtige E-Commerce-Aktion. Variante B performt deutlich schlechter und kostet dich spürbar Umsatz.
Mit bayesianischem A/B Testing kannst du die Variante sofort stoppen. Du musst nicht bis zum geplanten Testende warten.
Umgekehrt kannst du bei einer klar überlegenen Variante B früher mehr Traffic auf den Gewinner lenken als mit einem klassischen frequentistischen Verfahren.
Genau darauf basiert die Funktion der dynamischen Traffic-Verteilung. Ohne bayesianische Statistik wäre sie in dieser Form nicht möglich.
Wie funktioniert dynamische Traffic-Verteilung?
Dynamische Traffic-Verteilung schafft ein Gleichgewicht zwischen Exploration (also dem Sammeln verlässlicher Daten) und Exploitation, der Maximierung von Conversions.
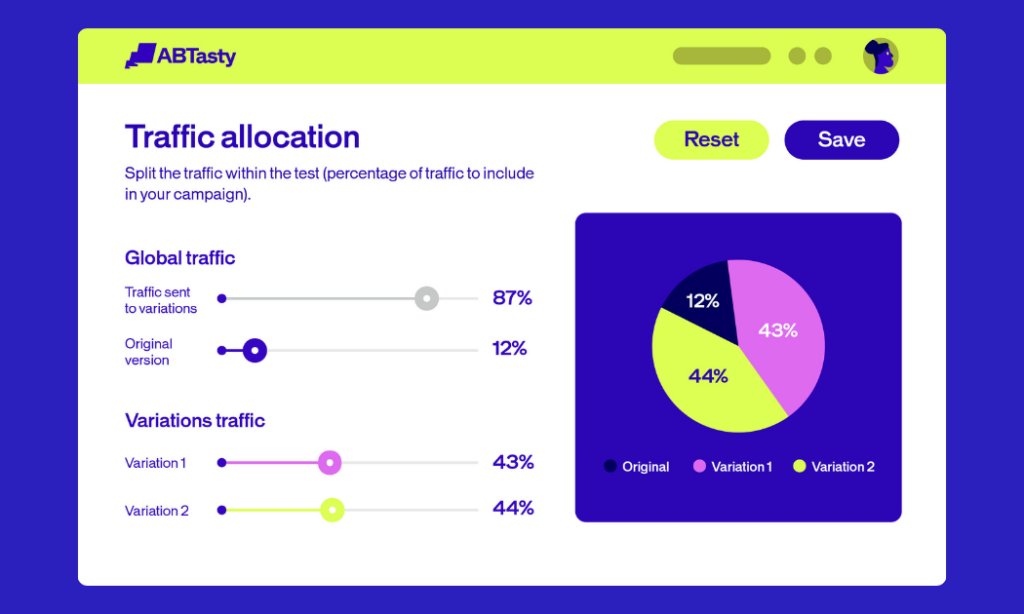
In der Praxis gehst du so vor:
- Aktiviere dynamische Traffic-Verteilung.
- Wähle deinen wichtigsten KPI.
- Lass den Algorithmus entscheiden, wann mehr Traffic an den Gewinner geht.
Besonders geeignet ist der Ansatz für:
- Micro-Conversions in kurzen Testzeiträumen
- zeitlich begrenzte Kampagnen wie Sales rund um Feiertage oder Blitzangebote
- Seiten mit geringem Traffic
- Tests mit sechs oder mehr Varianten gleichzeitig
Auch hier zeigt sich der Unterschied: Frequentistische Verfahren eignen sich nicht in gleicher Weise für sicheres kontinuierliches Monitoring und eine dynamische Traffic-Verteilung wie bayesianische Methoden.
Falsch-positive Ergebnisse im bayesianischen A/B Testing
Ein falsch-positives Ergebnis liegt vor, wenn ein Test suggeriert, dass Variante B besser performt, obwohl sie in Wirklichkeit keinen Vorteil bietet. Häufig ist Variante B dann nicht schlechter als A, sondern schlicht gleich gut.
Falsch-positive Ergebnisse können beim A/B Testing mit beiden Methoden auftreten. Der größte Unterschied liegt darin, welche Auswirkungen sie auf deine Umsetzung haben.
Wie begrenzt bayesianisches Testing falsch-positive Ergebnisse?
Bayesianisches A/B Testing weist ein Uplift-Intervall aus, weshalb du vermeintliche Gewinner mit geringem wirtschaftlichem Nutzen seltener umsetzt.
Beispiel: Variante B gewinnt mit 95 % Wahrscheinlichkeit, der mediane Uplift liegt aber nur bei 1 %. Selbst wenn das Ergebnis statistisch positiv erscheint, wirst du diese Variante wahrscheinlich nicht umsetzen, weil der geringe Effekt den Aufwand kaum rechtfertigt.
Beim frequentistischen Ansatz fehlt dieses Uplift-Intervall. Dadurch besteht eher die Gefahr, Zeit und Ressourcen in eine Änderung zu investieren, die keinen messbaren Mehrwert erzeugt.
Gewinnwahrscheinlichkeit mit bayesianischer Statistik
Als gängiger Richtwert gilt ein Konfidenzniveau von 95 % , also eine 95-prozentige Wahrscheinlichkeit, dass Variante B wie ausgewiesen performt, bei einem Restrisiko von 5 %.
Für die meisten Kampagnen ist dieser Wert ausreichend. Bei besonders wichtigen Vorhaben – etwa großen Produktlaunches oder geschäftskritischen Tests – kannst du die Schwelle auf 97 %, 98 % oder sogar 99 % erhöhen.
Beachte jedoch: Unabhängig von der Methode benötigst du für eine höhere Sicherheit mehr Zeit und mehr Traffic, um statistische Signifikanz zu erreichen. Wenn Präzision der wesentliche Faktor ist, kann sich dieser Zielkonflikt lohnen.
Für risikoreiche Kampagnen sind diese hohen Konfidenzniveaus sinnvoll. Als allgemeine Standardregel eignet sich eine höhere Schwelle jedoch nicht.
Dafür gibt es drei Gründe:
- Du musst länger auf Ergebnisse warten und hast dadurch weniger Zeit, von einem positiven Ergebnis zu profitieren.
- Du identifizierst faktisch nur noch Gewinner mit größerem Uplift. Diese sind seltener, während kleinere, aber dennoch wertvolle Verbesserungen durchs Raster fallen können.
- Bei geringem Traffic kann ein anderer Ansatz sinnvoller sein.
Fazit
Welche Methode ist also besser – frequentistisch oder bayesianisch?
Beide Ansätze sind statistisch fundiert. Wingify setzt dennoch auf bayesianisches A/B Testing, weil es Teams dabei unterstützt, bessere Geschäftsentscheidungen zu treffen.
Die wichtigsten Vorteile:
- Flexibilität: Du kannst Zwischenergebnisse prüfen, ohne die Aussagekraft der Analyse zu beeinträchtigen.
- Umsetzbare Erkenntnisse: Du kennst nicht nur den Gewinner, sondern auch welchen Umsatzbeitrag du erwarten kannst.
- Höhere Erträge: Die dynamische Traffic-Verteilung optimiert automatisch.
- Weniger Fehlentscheidungen: Die Methode bietet zusätzliche Orientierung bei falsch-positiven Ergebnissen.
Achte bei der Auswahl einer A/B-Testing-Plattform darauf, dass sie Ergebnisse liefert, denen du vertrauen kannst und aus denen du konkrete Maßnahmen ableiten kannst.
Möchtest du bayesianisches A/B Testing in der Praxis erleben? Mit Wingify kannst du Tests unkompliziert aufsetzen, Erkenntnisse über ein ROI-Dashboard auswerten und erkennen, welche Änderungen deinen Umsatz steigern.
Bereit für den nächsten Schritt? Lass uns gemeinsam bessere digitale Erlebnisse schaffen →
Frequentistische Methoden prüfen am Ende des A/B Testings anhand eines p-Werts, ob sich Varianten unterscheiden. Bayesianische Methoden schätzen zusätzlich den zu erwartenden Umsatzbeitrag und aktualisieren Ergebnisse fortlaufend, sobald neue Daten eingehen.
Beim bayesianischen A/B Testing ist das möglich. Die Methode eignet sich für laufende Analysen. Beim frequentistischen Ansatz kann häufiges vorzeitiges Prüfen zu irreführenden Ergebnissen führen, weil aus einem Experiment faktisch mehrere statistische Prüfungen werden.
Ein falsch-positives Ergebnis liegt vor, wenn Variante B scheinbar besser performt, obwohl sie tatsächlich keinen Vorteil bietet. Bayesianische Methoden begrenzen solche Fehlentscheidungen, weil sie ein Uplift-Intervall ausweisen. Damit werden geringe oder wirtschaftlich bedeutungslose Effekte sichtbar.
Für die meisten Marketingkampagnen sind 95 % ein gängiger Richtwert. Bei besonders risikoreichen Tests kannst du 97 %, 98 % oder 99 % ansetzen. Um die statistische Signifikanz zu erreichen, benötigst du allerdings mehr Zeit und Traffic. Das gilt sowohl für die frequentistische als auch die bayesianische Methode.
Wingify empfiehlt, dass ein A/B-Test mindestens 14 Tage beziehungsweise zwei Geschäftszyklen laufen sollte. Er sollte zudem mindestens 5.000 Unique Visitors pro Variante und 300 Conversions auf das Hauptziel erreichen. Diese Richtwerte liefern bei beiden Methoden verlässliche Ergebnisse.
Dynamische Traffic-Verteilung ist eine automatisierte Funktion, die Datenerhebung und Conversion-Maximierung ausbalanciert. Sobald der Algorithmus einen Gewinner mit ausreichender Sicherheit erkennt, leitet er automatisch mehr Traffic auf diese Variante und sammelt weiterhin mithilfe der bayesianischen Methode zuverlässige Daten.
Über den Autor
Hubert Wassner
Hubert Wassner ist Chief Data Scientist bei Wingify und verfügt über mehr als 30 Jahre Erfahrung in AI und Machine Learning. Er entwickelt fortschrittliche statistische Modelle, teilt seine Expertise im Blog und unterstützt Marken dabei, datenbasierte Entscheidungen zu treffen. Zu seinen jüngsten Erfolgen zählt ein Patent für RevenueIQ.
Categories:
Hubert Wassner is Chief Data Scientist at AB Tasty with over thirty years of experience in AI and machine learning. He builds advanced statistical models, shares insights on the blog, and helps brands make confident, data-driven decisions. His most recent achievement is obtaining a patent for RevenueIQ.